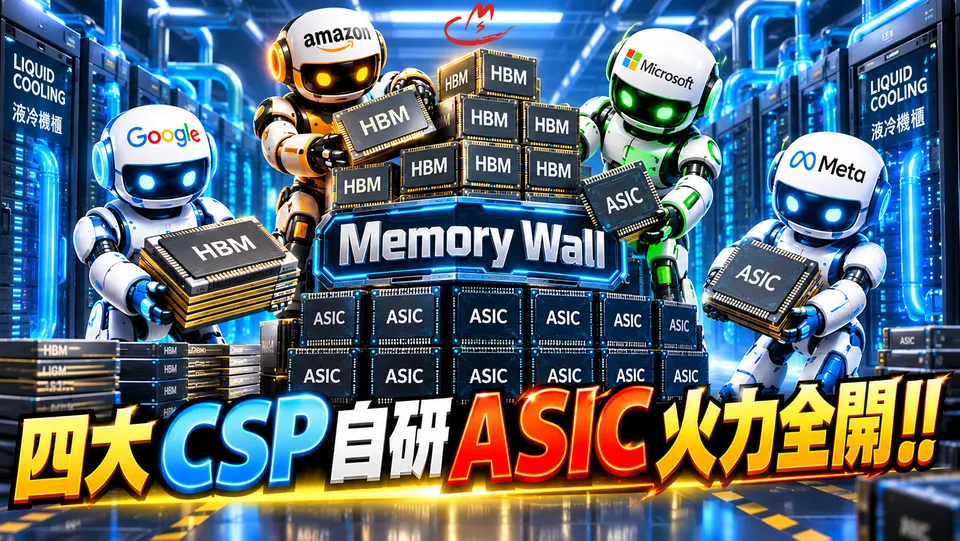
AI 算力戰轉向:四大 CSP 自研 ASIC。搶破「記憶體牆」與全液冷革命!
隨著 AI 商業化加速,雲端資料中心運算重心已從「基礎模型訓練」全面跨入「代理式 AI(Agentic AI)與長文本推論」。資料中心超過 7 成的電力與算力消耗轉向推論負載,運算瓶頸也從純粹的算力(FLOPS)轉移至「記憶體牆」與百千瓦級的散熱極限。
一、 轉向自研 ASIC:極致 Token 經濟學
為擺脫對高昂商用 GPU 的依賴並提升 Token 產出效率,北美四大雲端服務業者(CSP)加速部署自研 ASIC:
-
Google 谷歌:TPU v7/v8 專為推論時代與記憶體頻寬最佳化設計。
-
Microsoft 微軟:Maia 200/300 捨棄傳統訓練邏輯,每瓦電力產出 Token 較商用 GPU 提升 1.7 倍以上。
-
Amazon 亞馬遜:Trainium 3/4 主打代理式 AI,將訓練與推論合為一體。
-
Meta:MTIA 系列堅持推論優先,採兩年四代的敏捷硬體架構。
二、 攻克記憶體牆:先進製程與 HBM4 規格賽
推論過程中,龐大的模型權重與 KV Cache 搬移極度依賴頻寬。2026 年 ASIC 普遍採用台積電 3nm 與 HBM3e,單晶片記憶體容量達 144~216GB;下一代產品(如 Maia 300)將推進至 2nm 與 HBM4(288GB),透過 8 顆 HBM4 堆疊將單晶片頻寬推升至 18TB/s,全力挑戰長文本與多模態推論極限。
三、 物理極限逼出「全液冷整機櫃」
受限於 CoWoS 封裝晶圓曝光面積極限,單晶片無法獨立承載推論所需的 10TB~25TB HBM。CSP 業者透過垂直擴展(Scale-up)架構,將 48 至 144 顆 ASIC 整合於單一機櫃,使其在軟體端運作如同一顆巨型晶片。
這種高密度架構導致單機櫃功耗突破 100kW,逼迫硬體交付從傳統伺服器全面轉向高密度全液冷整機櫃系統。這場硬體型態革命,也同步帶動台灣半導體、伺服器組裝、PCB 與液冷散熱供應鏈的全面價值升級。